多语言本地化平台性能优化
写于 2024-09-24
为什么需要进行请求并发来优化?
背景
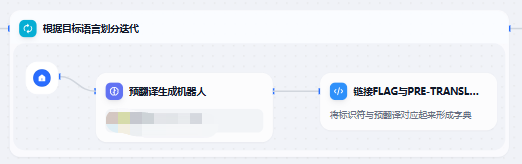
在 Dify 的工作流定义当中,倘若碰到 LLM 需要接收可迭代对象(比如数组)作为参数的情形,为了加快⏩ LLM 生成答案的速度,我们能够思考把可迭代对象中的 n 项当作原本每次请求 LLM 的参数。如此一来,原本只请求一次 LLM 的操作,将转变为请求 n 次 LLM ,如下图:
问题
在 Dify 中,这里的迭代是同步进行的,意味着每次仅会执行一次迭代内的工作。那么假设执行一次迭代的平均时间是t,迭代的次数为n,则总时间 T1 ≈ n * t。
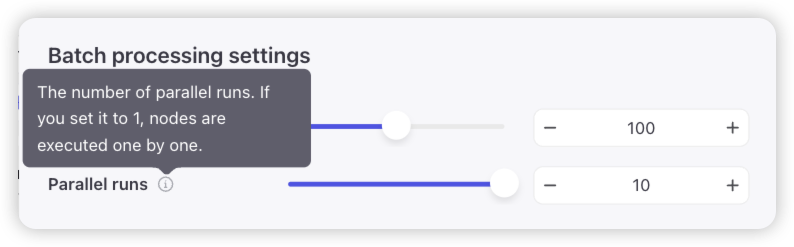
然而在 Coze 中,LLM 的执行能够配置为Batch processing(批处理)模式,同样是把可迭代的操作从 1 次变为n次。其不同之处在于,通过配置Parallel runs参数,可以设定 LLM 节点同时执行的数量,这表明 Coze 的批处理模式是能够并发执行的。那么其执行的总时间(假如总调用次数 <= Parallel runs)为T2 = Max(t1,t2,t3,...) ≈ t,并且通常情况下 T2 < T1是成立的。
既然 Dify 没有提供并发的方式,我们就需要从请求接口的方向考虑并发的可能性。
另外一些注意事项
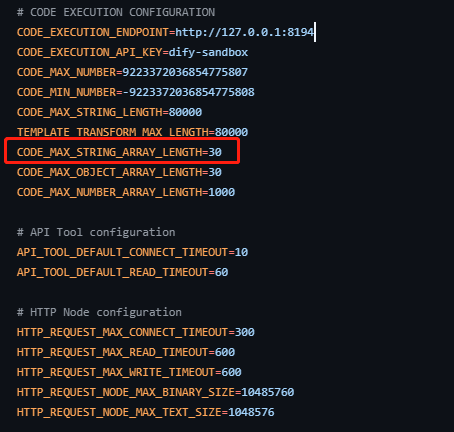
- Dify 设置了一些变量的最大个数,比如字符串,Object数组的长度最大为30,数字字符串的长度最大为1000。所以当我们的中间变量可以超过这个限制的话,我们可以考虑将中间变量使用
JSON.stringify进行字符串转化(最大长度为80000),当需要使用的时候,通过在代码节点里面使用JSON.parse进行转化即可。
- 一个迭代最大执行的轮数为
50。
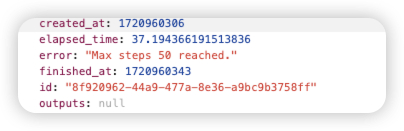
- 在实际运用中,当LLM一次性处理的复杂文案数量在一定数量时,容易出现生成标识符的大模型会出现缺漏掉一些数量文案标识符的现象,这对于我们平台整体的可靠性与稳定性是有相当大部分的影响,判断是超出LLM一次性可返回的Token数导致的。
如何进行的优化?
工作流S1 - 获取唯一标识符号Flags以及预翻译
请求参数
 interface getFlagsPretranslationsParams {
  originContent: {
    "zh-CN": string[];
  },
  targetLanguages: string[]; //需要进行翻译的目标语言
}

interface getFlagsPretranslationsResponse {
  flags: string[];
  preTranslations: {
    [p: string]: { // 多语言标识,如zh-CN, zh-TW等
      [p: string]: string // 唯一标识符以及对应的翻译结果
    }
  }
}

/**
 * 异步获取预翻译相关的标志和翻译数据
 * @function get_flags_pre_translations
 * @async
 * @param {Object} params - 输入的参数对象
 * @property {Object} params.originContent - 代表原始的翻译文案
 * @property {string[]} params.originContent["zh-CN"] - 固定的键,值为字符串数组
 * @property {string[]} params.targetLanguages - 代表需要进行翻译的语言数组
 * @returns {Object} 包含标志和预翻译数据的对象
 * @property {string[]} flags - 每个原始文案对应的唯一标识符数组
 * @property {Object} preTranslations - 预翻译数据对象
 * @property {Object} preTranslations["zh-CN"] - 以"zh-CN"为键,值为包含 flag 和对应翻译的对象
 * @property {Object} preTranslations[{targetLanguage}] - targetLanguage为以目标语言为键(例如 "zh-TW"、"en-US" 等),值为包含 flag 和对应翻译的对象
 */
const get_flags_pre_translations =
      async (params: getFlagsPretranslationsParams): getFlagsPretranslationsResponse => {
  			// ...
			}
并发策略的设置
客观限制
- 谷歌浏览器对同一域名下的并发请求数量进行了限制,这个限制为6个
- 目前需要支持的语言个数为16个
接口限制
- 每次接收到原始文案后,会针对原始文案去生成唯一标识符号,每次请求可能返回的标识符不一致
因此对于工作流S1的并发请求方式,我们使用按照20个文案+3个语言数的颗粒度来对请求进行拆分,并且为了保证不同语言的文案返回的标识符应一致的情况,工作流S1将包含「获取文案标识符」以及「获取文案预翻译」两个步骤,并且在「获取文案标识符」的分支上,涵盖了标识符缺漏检查的工作流程,进一步保证结果的完整性。
最终,拆解完成的工作流如下所示:
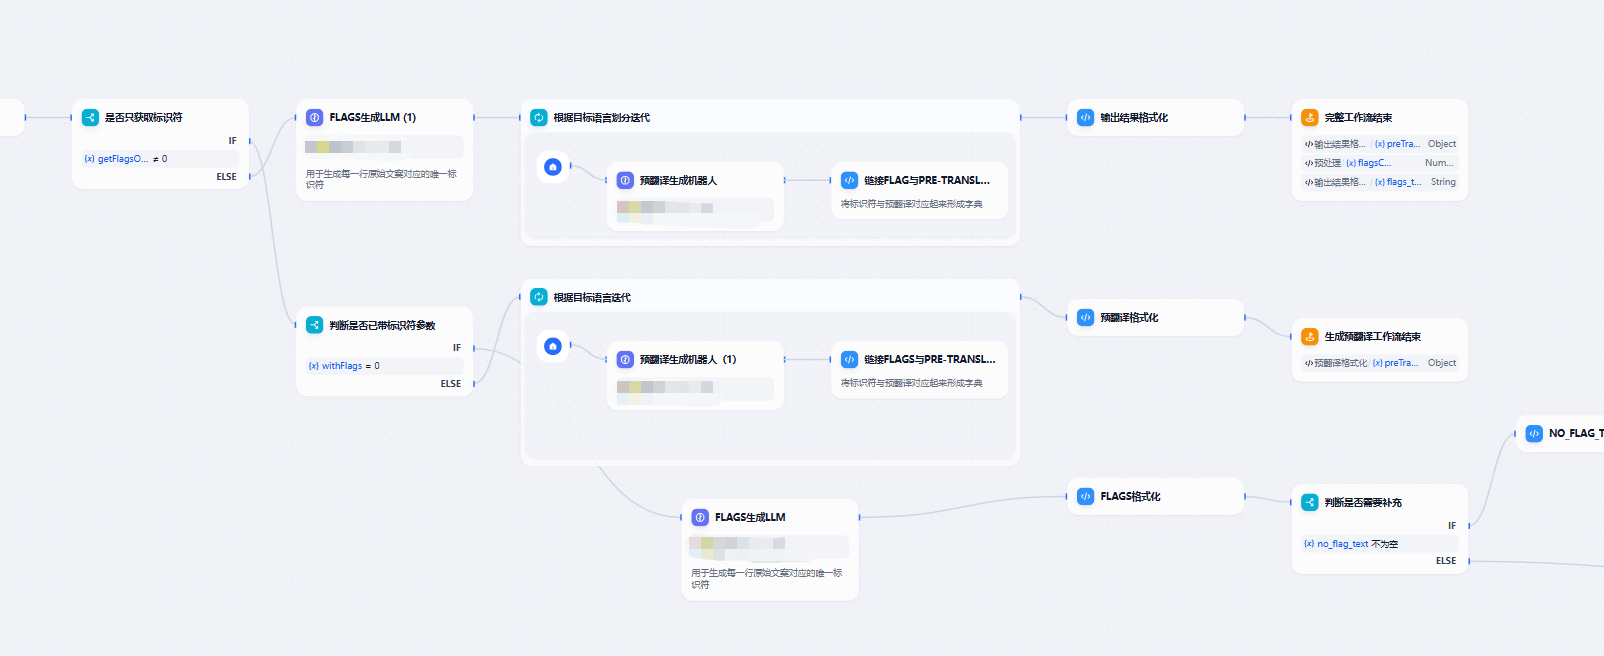
在代码层面上,S1将针对两类不同请求的方式走不同的工作流:
代码如下:
 /**
 * @description 分割请求获取标识符
 */
const flagChunkSize = 20;
export const batchGetFlags = async () => {
  // 切割
  const originContent = preprocessOriginContent(originContentObj);
  const requests = [];
  for (let i = 0; i < originContent['zh-CN'].length; i += flagChunkSize) {
    const flagsChunk = originContent['zh-CN'].slice(i, i + flagChunkSize);
    requests.push({
      originContent: JSON.stringify({
        'zh-CN': flagsChunk,
      }),
      targetLanguages: JSON.stringify(targetLanguages.value),
    });
  }
  const promises = requests.map(async (param) => {
    const r = await get_flags(param);
    return JSON.parse(r.flags);
  });
  const ress = await Promise.all(promises);
  // 遍历ress,将flags合并,假如flag有重复的,后面重复的flag需要加上后缀id,如flag1
  let flagsRess: string[] = [];
  let idxMap = new Map();
  ress.forEach((flags: string[]) => {
    flags.forEach((flag: string) => {
      if (flagsRess.includes(flag)) {
        let idx = idxMap.get(flag) || 0;
        idx += 1;
        idxMap.set(flag, idx);
        flagsRess.push(`${flag}${idx}`);
      } else {
        flagsRess.push(flag);
      }
    });
  });
  flags.value = flagsRess;
};
/**
 * @description 分割请求获取预翻译
 */
export const batchGetPreTranslations = async () => {
  const requests: GetFlagsPreTranslationsParams[] = [];
  const originContentProcessed = preprocessOriginContent(originContentObj);
  const flagReferences: {
    [key: string]: string;
  } = {};
  flags.value.forEach((flag, index) => {
    flagReferences[flag] = originContentProcessed['zh-CN'][index];
  });
  for (let i = 0; i < targetLanguages.value.length; i += langChunkSize) {
    const languageChunk = targetLanguages.value.slice(i, i + langChunkSize);
    for (let j = 0; j < flags.value.length; j += flagChunkSize) {
      const flagChunk = flags.value.slice(j, j + flagChunkSize);
      const flagReferencesChunk: {
        [key: string]: string;
      } = {};
      flagChunk.forEach((flag) => {
        flagReferencesChunk[flag] = flagReferences[flag];
      });
      const originContentChunk = {
        'zh-CN': originContentProcessed['zh-CN'].slice(j, j + flagChunkSize),
      };
      requests.push({
        originContent: JSON.stringify(originContentChunk),
        targetLanguages: JSON.stringify(languageChunk),
        flagReferences: JSON.stringify(flagReferencesChunk),
        flags: JSON.stringify(flagChunk),
      });
    }
  }
  const promises = requests.map(async (param) => {
    const r = await get_pre_translations(param);
    return {
      preTranslations: r.preTranslations,
    };
  });
  Object.assign(preTranslations.value, {
    'zh-CN': {},
  });
  const ress = await Promise.all(promises);
  ress.forEach((res: {
    preTranslations: PreTranslation
  }) => {
    // Object.assign(preTranslations.value, postprocessPreTranslations(res?.preTranslations));
    for (const lang in res.preTranslations) {
      if (!preTranslations.value[lang]) {
        preTranslations.value[lang] = {};
      }
      Object.assign(preTranslations.value[lang], postprocessPreTranslations(res.preTranslations)[lang]);
    }
  });
};
/**
 * @description 分开请求标识符与预翻译
 */
export const batchGetFlagsAndPreTranslationsOpt = async () => {
  const start = performance.now();
  await batchGetFlags();
  await batchGetPreTranslations();
  const end = performance.now();
  console.log(`共花费: ${end - start}ms`);
  const duration = end - start;
};
工作流S2 - 获取翻译的优化建议
请求参数
 interface getTranslationsSuggestionsParams {
  flags: string[]; // 工作流S1返回的唯一标识符数组
  preTranslations: {
    [p: string]: { // 多语言的标识,如zh-CN, zh-TW等
      [p: string]: string // 唯一标识符以及其对应的翻译结果
    }
  }
}

interface getTranslationsSuggestionsResponse {
  suggestions: {
    [p: string]: { // 多语言的标识,如zh-CN, zh-TW等
      [p: string]: { // 唯一标识符
        suggestion: string; // 建议优化后的修改结果
        reason: string; // 建议的原因
      }
    }
  }
}
/**
 * 异步获取翻译建议的函数
 * @function get_translation_suggestions
 * @async
 * @param {getTranslationsSuggestionsParams} params - 输入的参数对象
 * @typedef {Object} getTranslationsSuggestionsParams
 * @property {string[]} flags - 工作流 S1 返回的唯一标识符数组
 * @property {Object} preTranslations - 多语言的翻译数据
 * @property {string} preTranslations[p] - 多语言的标识,如 zh-CN, zh-TW 等
 * @property {Object} preTranslations[p][p] - 唯一标识符及其对应的翻译结果
 * @returns {getTranslationsSuggestionsResponse} 包含翻译建议的响应对象
 * @typedef {Object} getTranslationsSuggestionsResponse
 * @property {Object} suggestions - 多语言的翻译建议
 * @property {string} suggestions[p] - 多语言的标识,如 zh-CN, zh-TW 等
 * @property {Object} suggestions[p][p] - 唯一标识符对应的建议详情
 * @property {string} suggestions[p][p].suggestion - 建议优化后的修改结果
 * @property {string} suggestions[p][p].reason - 建议的原因
 */
const get_translation_suggestions = async (params: getTranslationsSuggestionsParams): getTranslationsSuggestionsResponse => {//...}
const get_translation_suggestions =
      async (params: getTranslationsSuggestionsParams): getTranslationsSuggestionsResponse => {
        //...
      }
并发策略的设置
- 客观限制:与S1一致
- 接口限制:无,因为
suggestions返回了需要的两个确认的索引,分别是语言的标识符以及翻译内容的标识符。
综上所述,在此接口中,我们能够针对目标语言以及需要进行优化检测的翻译内容分别予以分割后再进行请求,原因在于返回的结果必然是唯一对应的。
所以,相应的策略如下:语言的分割维度设定为3,与 S1 保持一致;而对于翻译内容,或者说是依据标识符数组来进行分割,当前维度设置为20,不过这个后续或许还需要逐步进行调优。
切割的实现
 // 按语言+flag进行分割
const chunkSize = 20;
export const batchGetSuggestions = async () => {
  const requests: GetTranslationSuggestionsParams[] = [];
  const preTranslationProcessed = preprocessPreTranslations(preTranslations.value)
  const targetLanguages = Object.keys(preTranslationProcessed);
  const idx = targetLanguages.indexOf("zh-CN");
  if (idx !== -1) {
    // 先剔除目标语言里面的zh-CN,避免分割的时候算上了这个语言
    targetLanguages.splice(idx, 1);
  }
  for (let i = 0; i < targetLanguages.length; i += langChunkSize) {
    const languageChunked = targetLanguages.slice(i, i + langChunkSize);
    // console.log(languageChunked);
    // 需要加入中文,因为工作流需要references
    languageChunked.push("zh-CN");
    for (let j = 0; j < flags.value.length; j += chunkSize) {
      const flagsChunked = flags.value.slice(j, j + chunkSize);
	  // 把preTranslationProcessed中的flags也进行截取
      const preTranslationParam: PreTranslation = {};
      languageChunked.forEach((lang) => {
        preTranslationParam[lang] = {}
        flagsChunked.forEach((flag) => {
          preTranslationParam[lang][flag] = preTranslationProcessed[lang][flag]
        })
      })
      // console.log(preTranslationParam);
      // console.log(flagsChunked);
      requests.push({
        contents: JSON.stringify(preTranslationParam),
        flags: JSON.stringify(flagsChunked)
      })
    }
  }
  const promises = requests.map(async (param) => {
    const r = await get_translation_suggestions(param);
    return {
      suggestions: r.suggestions
    }
  });
  console.time('batchGetSuggestionsTime');
  const ress = await Promise.all(promises);
  console.timeEnd('batchGetSuggestionsTime');
	// 将返回的结果回填
}
优化效果
我们运用 console.time() 以及 console.timeEnd() 来对请求的时间予以记录,每种情况均通过三次测试并取平均值进行对比,以此来评判优化的成效。
获取唯一标识符以及预翻译的测试
| id | 文案行数 * 语言数量 | 非并发平均耗时(ms) | 并发平均耗时(ms) | 优化比例 |
|---|---|---|---|---|
| 1 | 2*1 | (4289+3397+3411)/3=3699 | (4053+4573+3711)/3=4112 | -11% |
| 2 | 2*4 | (8289+8359+8924)/3=8524 | (7020+7926+7676)/3=7540 | 11% |
| 3 | 2*7 | (13229+14217+13543)/3=13663 | (8546+6837+7732)/3=7705 | 43% |
| 4 | 2*10 | (19211+18196+19079)/3=18828 | (7321+7138+7422)/3=7293 | 61% |
| 5 | 2*13 | (22145+23255+23026)/3=22808 | (8951+7454+8002)/3=8135 | 64% |
| 6 | 2*16 | (27909+26960+36719)/3=30529 | (7706+7528+8057)/3=7763 | 74% |
| 7 | 13*4 | (43586+34579+32705)/3=36956 | (27574+24812+27277)/3=26554 | 28% |
| 8 | 13*16 | (157709+130520+141288)/3=143172 | (31573+39354+33238)/3=34721 | 75% |
| 9 | 53*16 | (151433+129462+141963)/3=140952 | (36676+41878+47155)/3=41903 | 70% |
获取优化建议测试
| id | 文案行数 * 语言数量 | 非并发平均耗时(ms) | 并发平均耗时(ms) | 优化比例 |
|---|---|---|---|---|
| 1 | 2*1 | (3954+5904+5663)/3=3973 | (3899+3352+3708)/3=3653 | 8% |
| 2 | 2*4 | (11107+10204+12205)/3=11172 | (12160+7236+9417)/3=9604 | 14% |
| 3 | 2*7 | (20030+19322+19937)/3=19763 | (8446+8678+9778)/3=8967 | 54% |
| 4 | 2*10 | (25645+25295+26702)/3=25880 | (9108+9106+11746)/3=9986 | 61% |
| 5 | 2*13 | (31283+41076+36197)/3=36383 | (11825+11369+11445)/3=11546 | 68% |
| 6 | 2*16 | 请求失败 (Max steps 50 reached) | (12094+10565+9598)/3=11022 | 100% |
| 7 | 13*4 | (99145+97551+126297)/3=107664 | (30604+28750+28780)/3=29378 | 73% |
| 8 | 13*16 | 请求失败 (Max steps 50 reached) | (24659+28657+33146)/3=28820 | 100% |
| 9 | 53*16 | 请求失败 (Max steps 50 reached) | (96490+89632+77672)/3=87931 | 100% |
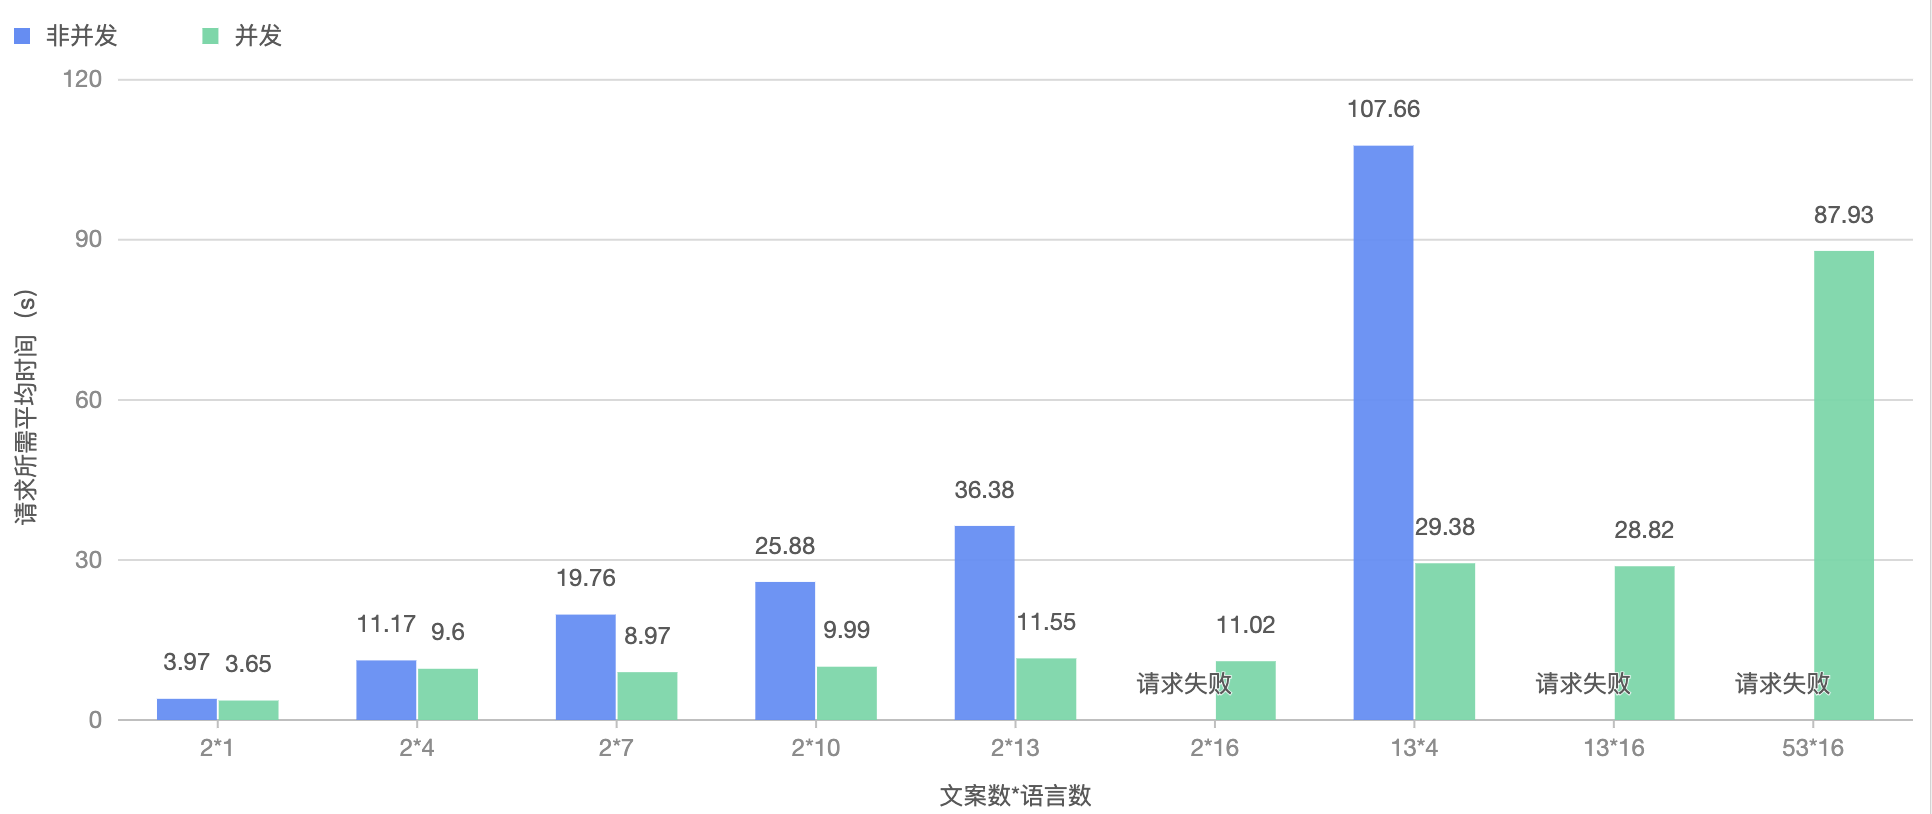
总结
- 如上表所示:在生成唯一标识符号工作流中,并发平均节省时间为43%。并且随着语言数量,可以看到并发的优势将越来越大,最大的可节省约75%的时间;而在获取翻译的优化建议工作流中,平均节省时间为64%。并且随着语言数量的增加,优化效果也会逐渐增强,最大的可节省时间约为73%,并且非并发请求受到了最大步数的限制而请求失败时,并发请求可以正常执行。
- 通过并发的方式,我们能够在一定程度上提高工作流的执行效率,尤其是在大量数据的情况下,优化效果更为明显。